Noonbolt e Data Science: dai dati alle decisioni per la mobilità
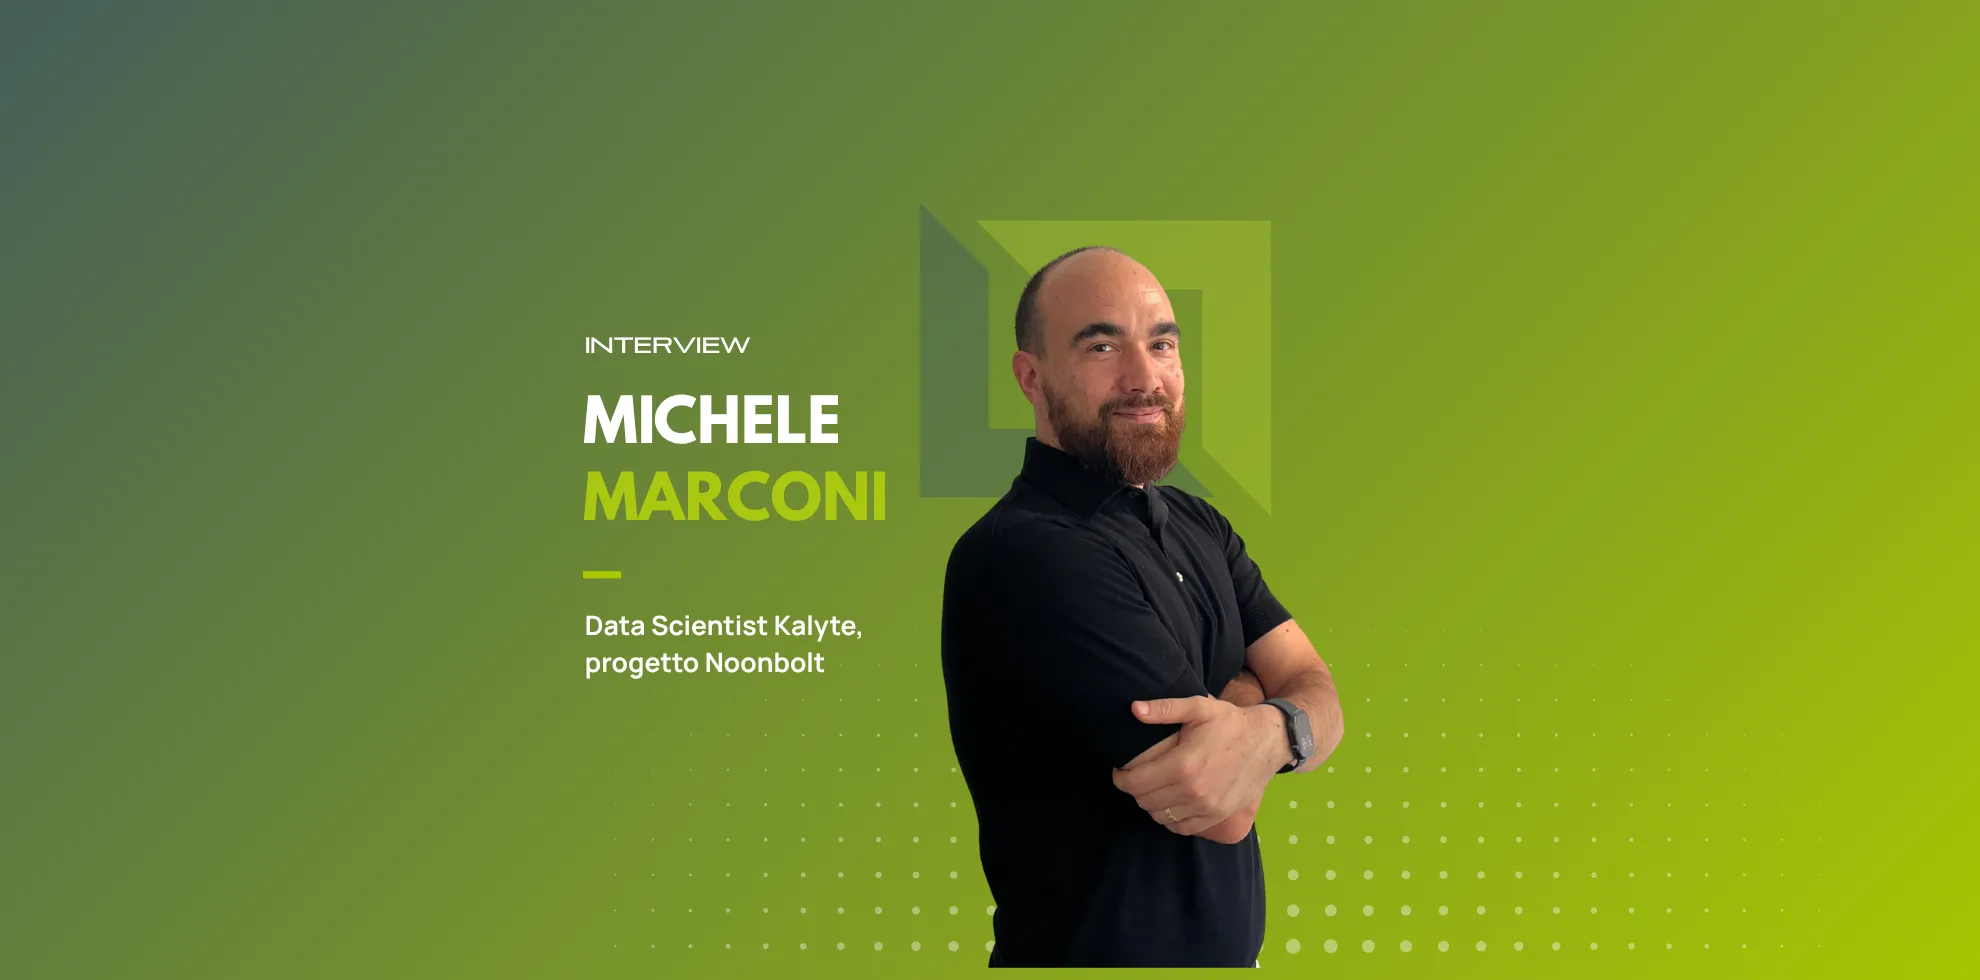
Come trasformare dati e modelli in decisioni migliori? Michele Marconi illustra la ricerca Noonbolt sul trasporto a chiamata, la vigilanza del driver e le batterie.
Dalla pianificazione del trasporto a chiamata al monitoraggio dei segnali di affaticamento del conducente, fino ai modelli predittivi per la batteria: dietro la ricerca di Noonbolt sulla mobilità di nuova generazione ci sono dati, simulazioni, confronti tra algoritmi e validazione sperimentale. Ne parliamo con Michele Marconi, Data Scientist di Kalyte impegnato sul progetto Noonbolt, per capire come un’ipotesi tecnica possa diventare uno strumento utile per operatori, conducenti e passeggeri.
Il filo rosso dei progetti su cui stai lavorando sembra essere trasformare dati molto diversi tra loro in decisioni operative. È questa la vera sfida?
Sì. Il punto non è semplicemente avere dati o applicare un algoritmo, ma costruire una catena affidabile che vada dalla misura alla decisione. Nel nostro caso lavoriamo con dati geospaziali, richieste di mobilità, telemetria video e variabili di batteria. Cambiano le sorgenti, ma il metodo resta simile: definire bene il problema, scegliere metriche significative, costruire un modello, testarlo su scenari controllati e capire dove fallisce. Una parte importante è distinguere sempre ciò che osserviamo da ciò che stiamo assumendo. La Data Science diventa utile quando non produce soltanto una previsione, ma aiuta a prendere una decisione migliore: assegnare un mezzo, proporre un orario, riconoscere un segnale di affaticamento o pianificare in anticipo un intervento sulla batteria.
Partiamo dal trasporto a chiamata. Cosa rende complesso un sistema DRT rispetto a una linea tradizionale?
Nel Demand Responsive Transport la domanda non è completamente nota in anticipo: alcune prenotazioni arrivano mentre i mezzi sono già in servizio. Il pianificatore deve quindi rispettare contemporaneamente puntualità, capienza, tempo massimo a bordo, autonomia e costo operativo. Ogni nuova richiesta può modificare l’equilibrio del piano, ma senza compromettere gli impegni già presi con gli utenti. Abbiamo lavorato su un modello indipendente dal luogo, costruendo la rete stradale a partire da OpenStreetMap e rappresentandola tramite celle H3. Su questa base confrontiamo diverse strategie di pianificazione e riottimizzazione, cercando un equilibrio tra qualità del servizio, chilometri percorsi e capacità di assorbire richieste che arrivano durante la giornata.
Nel benchmarking avete confrontato algoritmi anche molto sofisticati. Come si capisce qual è davvero quello più adatto?
La cosa essenziale è confrontarli nelle stesse condizioni. Abbiamo messo a confronto inserimento greedy, tabu search e ALNS usando la stessa domanda e gli stessi vincoli; su istanze piccole abbiamo anche costruito un enumeratore esatto, per avere un riferimento rispetto all’ottimo. Il risultato interessante è che ottimizzare di più il piano non significa automaticamente servire più persone. Un algoritmo può comprimere molto bene le corse note in quel momento e, proprio
per questo, eliminare gli spazi utili a inserire le richieste che arriveranno dopo. Nel nostro scenario la logica greedy con riottimizzazione a finestra mobile si è dimostrata competitiva: riesamina periodicamente la parte modificabile del piano, senza cambiare gli orari già promessi. Nei sistemi dinamici, quindi, la politica di servizio può contare quanto la sofisticazione matematica dell’algoritmo.
In questo lavoro compare spesso H3. Perché utilizzare una griglia esagonale per rappresentare il territorio?
H3 ci permette di trasformare coordinate GPS e rete stradale in una struttura discreta, gerarchica e interrogabile in modo efficiente. In pratica, il territorio viene suddiviso in celle esagonali con un identificativo univoco; su queste celle possiamo collegare strade, richieste, percorsi e altri dati geolocalizzati. È utile perché semplifica molte query spaziali e ci consente di lavorare anche localmente, senza invocare continuamente servizi esterni. Ma soprattutto crea un linguaggio geografico comune: la stessa base può essere riutilizzata per analizzare domanda, routing, sensoristica urbana e, in prospettiva, dati operativi della flotta.
Un altro filone riguarda il Driver Fatigue Monitor. Come si trasforma un video del conducente in una misura quantitativa della vigilanza?
Il prototipo parte dai landmark facciali rilevati con MediaPipe e misura la geometria dell’occhio attraverso l’EAR, l’Eye Aspect Ratio. Da lì ricaviamo il numero e la durata dei blink e soprattutto il PERCLOS, cioè la percentuale di tempo in cui gli occhi risultano profondamente chiusi all’interno di una finestra temporale. Il sistema lavora quindi su indicatori quantitativi derivati dal video, non su valutazioni soggettive. PERCLOS è interessante perché considera la durata complessiva delle chiusure profonde e può catturare fenomeni che il semplice conteggio dei blink non descrive. È però importante essere precisi: oggi il modulo produce telemetria quantitativa, non una diagnosi e non un allarme automatico.
Quindi il passaggio più delicato è trasformare queste misure in una vera logica di allerta?
Esatto, ed è proprio qui che serve ricerca prima ancora che sviluppo. Oggi abbiamo una pipeline che misura e serializza PERCLOS, numero di blink e durata delle chiusure; non abbiamo ancora introdotto un classificatore definitivo dello stato del conducente. Le soglie EAR sono globali e non calibrate sulla singola persona, mentre conformazione dell’occhio, occhiali, illuminazione e posizione rispetto alla camera possono modificare la misura. Anche il canale BPM presente nel prototipo è un mock e non un dato biometrico reale. Il passo successivo è validare le metriche su casi diversi, studiare la calibrazione e capire come combinare più segnali senza generare falsi allarmi. L’obiettivo è arrivare a una logica sufficientemente robusta da supportare davvero conducente e operatore.
Avete lavorato anche su modelli relativi alla batteria. Che differenza c’è tra Predictive Maintenance e Predictive Operations?
La Predictive Maintenance cerca di anticipare una condizione di degrado o di rischio per pianificare la manutenzione prima del guasto. La Predictive Operations usa invece la previsione per migliorare la gestione quotidiana: ad esempio decidere come impiegare il mezzo, quando ricaricarlo o quale missione assegnargli. Nei test preliminari abbiamo lavorato su variabili come capacità della batteria, temperatura, eventi di scarica profonda e permanenza in condizioni termiche critiche. Il modello mostrato finora ha ottenuto risultati promettenti sul campione analizzato, con balanced accuracy pari a 0,94. Il punto, però, non è fermarsi alla metrica: bisogna capire quali variabili stanno davvero guidando la previsione, se il comportamento resta stabile su altri dati e se l’output può essere tradotto in una decisione operativa utile.
Cosa accomuna, dal punto di vista scientifico, lavori apparentemente così diversi?
La cosa più importante è il metodo di validazione. Cerchiamo di non innamorarci dell’algoritmo: formuliamo un’ipotesi, la confrontiamo con alternative, misuriamo gli effetti sulla stessa domanda o sugli stessi dati e teniamo anche i risultati negativi. Nel DRT, per esempio, alcune metaeuristiche più sofisticate non hanno prodotto il vantaggio atteso; nel Driver Monitoring abbiamo volutamente separato la misura dall’allerta, perché introdurre una soglia non validata darebbe un’apparenza di precisione che oggi non abbiamo. Anche gli errori di modellazione sono informativi: correggere ipotesi non realistiche può cambiare la lettura del problema. La ricerca serve anche a capire quali risultati dipendono dal contesto e quali possono essere generalizzati.
Qual è quindi il beneficio finale che questo lavoro di ricerca può portare alla mobilità?
Il beneficio è rendere il sistema più adattivo, misurabile e capace di imparare dai dati di esercizio. Per un operatore significa poter pianificare meglio un servizio on-demand, usare in modo più efficiente i mezzi e anticipare condizioni che possono generare fermo o disservizio. Per il conducente significa poter disporre, in prospettiva, di sistemi di supporto basati su indicatori oggettivi di vigilanza. Per il passeggero significa un servizio più affidabile, con tempi e promesse gestiti in modo più coerente. La parte più interessante è che questi moduli non devono vivere isolati: routing, sensing, telemetria e modelli predittivi possono convergere in una stessa piattaforma. A quel punto il dato non serve solo a descrivere ciò che è successo, ma può contribuire a migliorare progressivamente le decisioni successive.
Quando possiamo dire che un prototipo di ricerca è pronto per diventare una soluzione?
Quando smette di funzionare soltanto nel caso in cui è nato. Servono dati reali, test su scenari diversi, calibrazione per contesto, metriche riproducibili e integrazione con i sistemi operativi. Serve anche conoscere i limiti: un modello può avere ottime prestazioni su un campione e non essere ancora pronto per un utilizzo operativo. È il passaggio che ci interessa di più: portare i modelli dal laboratorio a un ambiente in cui possano essere osservati, aggiornati e migliorati nel tempo. La ricerca diventa realmente utile quando sappiamo anche dove il modello non funziona, quali dati gli servono e come utilizzare il suo output in modo affidabile.